关于 Java 中 String 有用没用的知识,都在这里了
1 String 经历的两次重要变化 1.1 字符串常量池位置的改变 在 JDK6 及之前,字符串常量池位于永久代中;JDK7 开始,将字符串常量池移动到了堆空间中。作出这一改变的原因也很简单,因为永久代的回收效率很低,只在 Full GC 的时候才会执行永久代的垃圾回收,而 Full GC 是老年代的空间不足、永久代不足时才会触发,这就导致字符串常量池回收效率不高,实际开发中会有大量的字符串被创建,回收效率低就会导致永久代内存不足,而放到堆里就能及时回收内存。
1.2 String 结构的改变 在 JDK8 及以前 String 类内部定义了 final char value[] 用于存储字符串数据,JDK9 时改为 byte[]。
String 类的当前实现将字符存储在 char[] 中,每个字符使用两个字节
从许多不同的应用程序收集的数据表明,字符串是堆使用的主要组成部分,而且大多数字符串对象只包含拉丁字符(Latin-1),这些字符只需要一个字节的存储空间,因此这些字符串对象的内部 char 数组中有一半的空间将不会使用,产生了大量浪费
之前 String 类使用 UTF-16 的 char[] 数组存储,现在改为 byte[] 数组外加一个编码标识存储,该编码表示如果你的字符是 ISO-8859-1 或者 Latin-1,那么只需要一个字节存;如果你是其它字符集,比如 UTF-8,你仍然用两个字节存储
同时基于 String 的数据结构,StringBuffer 和 StringBuilder 也做了修改
1 2 3 4 5 6 7 8 9 10 11 12 public final class String { private final char value[]; } public final class String { @Stable private final byte [] value; private final byte coder; }
2 String Table 的底层结构 字符串常量池中是不会存储相同内容的字符串的
String 的字符串常量池是一个固定大小的 Hashtable。如果放进这个 Hashtable 的 String 非常多,就会造成 Hash 冲突严重,从而导致链表会很长,而链表长了后直接会造成的影响就是当调用 String.intern() 方法时性能会大幅下降
使用虚拟机参数 -XX:StringTableSize=60013 可设置 StringTable 的长度为 60013
在 JDK8 之后,StringTable 的长度默认值是 60013,StringTableSize 可以设置的最小值为 1009
测试不同 StringTable 长度下,程序的性能
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 public class GenerateString { public static void main (String[] args) throws IOException { FileWriter fw = new FileWriter ("words.txt" ); for (int i = 0 ; i < 100000 ; i++) { int length = (int )(Math.random() * 10 + 1 ); fw.write(getString(length) + "\n" ); } fw.close(); } public static String getString (int length) { StringBuilder sb = new StringBuilder (); for (int i = 0 ; i < length; i++) { int num = (int )(Math.random() * 26 + 65 ) + (int )(Math.random() * 2 ) * 32 ; sb.append((char ) num); } return sb.toString(); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public class StringTest { public static void main (String[] args) { BufferedReader br = null ; try { br = new BufferedReader (new FileReader ("words.txt" )); long start = System.currentTimeMillis(); String data; while ((data = br.readLine()) != null ){ data.intern(); } long end = System.currentTimeMillis(); System.out.println("花费的时间为:" + (end - start)); } catch (IOException e) { e.printStackTrace(); } finally { if (br != null ){ try { br.close(); } catch (IOException e) { e.printStackTrace(); } } } } }
3 String 如何分配到字符串常量池 在 Java 语言中有 8 种基本数据类型和一种比较特殊的类型 String,这些类型为了在运行过程中速度更快、更节省内存,都提供了一种常量池的概念。常量池就类似一个 Java 系统级别提供的缓存,8 种基本数据类型的常量池都是系统协调的。String 类型的常量池比较特殊,它的主要使用方法有两种:
4 String 拼接操作 Java 语言规范里要求完全相同的字符串字面量,应该包含同样的 Unicode 字符序列(包含同一份码点序列的常量),并且必须是指向同一个 String 类实例。
4.1 基本原则
4.2 常量与常量的拼接
1
2
3
4
5
6
7
public void test1 () { String s1 = "a" + "b" + "c" ; String s2 = "abc" ; System.out.println(s1 == s2); System.out.println(s1.equals(s2)); }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 0 ldc #2 <abc> 2 astore_1 3 ldc #2 <abc> 5 astore_2 6 getstatic #3 <java/lang/System.out : Ljava/io/PrintStream;> 9 aload_1 10 aload_211 if_acmpne 18 (+7 )14 iconst_115 goto 19 (+4 )18 iconst_019 invokevirtual #4 <java/io/PrintStream.println : (Z)V>22 getstatic #3 <java/lang/System.out : Ljava/io/PrintStream;>25 aload_126 aload_227 invokevirtual #5 <java/lang/String.equals : (Ljava/lang/Object;)Z>30 invokevirtual #4 <java/io/PrintStream.println : (Z)V>33 return
1 2 3 4 5 6 7 public void test1 () { String s1 = "abc" ; String s2 = "abc" ; System.out.println(s1 == s2); System.out.println(s1.equals(s2)); }
4.3 包含字符串变量的拼接
1
2
3
4
StringBuilder sb = new StringBuilder ();sb.append(s1); sb.append(s2); s3 = sb.toStirng();
从 JDK9 开始,String 变量连接操作被编译成使用 invokedynamic 指令,invokedynamic 指令使用的引导方法为 java.lang.invoke.StringConcatFactory.makeConcatWithConstants
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
public void test2 () { String s1 = "abc" ; String s2 = "def" ; String s3 = "abcdef" ; String s4 = "abc" + "def" ; String s5 = s1 + "def" ; String s6 = "abc" + s2; String s7 = s1 + s2; System.out.println(s3 == s4); System.out.println(s3 == s5); System.out.println(s3 == s6); System.out.println(s3 == s7); System.out.println(s5 == s6); System.out.println(s5 == s7); System.out.println(s6 == s7); String s8 = s6.intern(); System.out.println(s3 == s8); }
从字节码角度来看:在 JDK8 中拼接前后有变量,都会使用到 StringBuilder 类;在 JDK17 中,调用了引导方法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 13 new #9 <java/lang/StringBuilder> 16 dup 17 invokespecial #10 <java/lang/StringBuilder.<init> : ()V> 20 aload_1 21 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 24 ldc #7 <def> 26 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 29 invokevirtual #12 <java/lang/StringBuilder.toString : ()Ljava/lang/String;> 32 astore 5 34 new #9 <java/lang/StringBuilder> 37 dup 38 invokespecial #10 <java/lang/StringBuilder.<init> : ()V> 41 ldc #6 <abc> 43 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 46 aload_2 47 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 50 invokevirtual #12 <java/lang/StringBuilder.toString : ()Ljava/lang/String;> 53 astore 6 55 new #9 <java/lang/StringBuilder> 58 dup 59 invokespecial #10 <java/lang/StringBuilder.<init> : ()V> 62 aload_1 63 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 66 aload_2 67 invokevirtual #11 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;> 70 invokevirtual #12 <java/lang/StringBuilder.toString : ()Ljava/lang/String;> 73 astore 7
1 2 3 4 5 6 7 8 9 10 11 12 13 14 13 aload_1 14 invokedynamic #61 <makeConcatWithConstants, BootstrapMethods #0 > 19 astore 5 21 aload_2 22 invokedynamic #65 <makeConcatWithConstants, BootstrapMethods #1 > 27 astore 6 29 aload_1 30 aload_2 31 invokedynamic #66 <makeConcatWithConstants, BootstrapMethods #2 > 36 astore 7
4.4 字符串拼接的底层细节 非 final 修饰的 String 变量
见上一小节的代码。
有 final 修饰的 String 常量
字符串拼接操作不一定使用的是 StringBuilder。如果拼接符号左右两边都是字符串常量或常量引用,则仍然使用编译期优化。针对于 final 修饰类、方法、基本数据类型、引用数据类型的量的结构时,能使用上 final 的时候建议使用。
1
2
3
4
5
6
7
public void test3 () { final String s1 = "a" ; final String s2 = "b" ; String s3 = "ab" ; String s4 = s1 + s2; System.out.println(s3 == s4); }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
0 ldc #13 <a> 2 astore_1 3 ldc #14 <b> 5 astore_2 6 ldc #15 <ab> 8 astore_3 9 ldc #15 <ab> 11 astore 4 13 getstatic #3 <java/lang/System.out : Ljava/io/PrintStream;>16 aload_317 aload 4 19 if_acmpne 26 (+7 )22 iconst_123 goto 27 (+4 )26 iconst_027 invokevirtual #4 <java/io/PrintStream.println : (Z)V>30 return
拼接操作的执行效率
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 public void method1 (int highLevel) { String src = "" ; for (int i = 0 ; i < highLevel; i++){ src = src + "a" ; } } public void method2 (int highLevel) { StringBuilder src = new StringBuilder (); for (int i = 0 ; i < highLevel; i++) { src.append("a" ); } }
5 new String() 创建多少对象 5.1 new String(“ab”) 1 2 3 4 5 6 7 8 9 10 public class StringNewTest { public static void main (String[] args) { String str = new String ("ab" ); } }
1 2 3 4 5 6 7 0 new #2 <java/lang/String> 3 dup 4 ldc #3 <ab> 6 invokespecial #4 <java/lang/String.<init> : (Ljava/lang/String;)V> 9 astore_1 10 return
5.2 new String(“a”) + new String(“b”) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 public class StringNewTest { public static void main (String[] args) { String str = new String ("a" ) + new String ("b" ); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 0 new #2 <java/lang/StringBuilder> 3 dup 4 invokespecial #3 <java/lang/StringBuilder.<init> : ()V> 7 new #4 <java/lang/String> 10 dup11 ldc #5 <a>13 invokespecial #6 <java/lang/String.<init> : (Ljava/lang/String;)V>16 invokevirtual #7 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;>19 new #4 <java/lang/String>22 dup23 ldc #8 <b>25 invokespecial #6 <java/lang/String.<init> : (Ljava/lang/String;)V>28 invokevirtual #7 <java/lang/StringBuilder.append : (Ljava/lang/String;)Ljava/lang/StringBuilder;>31 invokevirtual #9 <java/lang/StringBuilder.toString : ()Ljava/lang/String;>34 astore_135 return
1 2 3 4 5 6 7 8 9 10 11 12 0 new #2 <java/lang/String> 3 dup 4 ldc #3 <a> 6 invokespecial #4 <java/lang/String.<init> : (Ljava/lang/String;)V> 9 new #2 <java/lang/String> 12 dup13 ldc #5 <b>15 invokespecial #4 <java/lang/String.<init> : (Ljava/lang/String;)V>18 invokedynamic #6 <makeConcatWithConstants, BootstrapMethods #0 >23 astore_124 return
5.3 String 类构造器 String 类提供了大量构造器方法,其中构造器 public String(String original) 代码如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 public final class String { @Stable private final byte [] value; private final byte coder; public String () { this .value = "" .value; this .coder = "" .coder; } public String (String original) { this .value = original.value; this .coder = original.coder; this .hash = original.hash; } }
6 intern() String 类提供了一个 intern() 方法,intern() 方法的官方介绍如下:
1 2 3 4 5 6 7 Returns a canonical representation for the string object. A pool of strings, initially empty, is maintained privately by the class String. When the intern method is invoked, if the pool already contains a string equal to this String object as determined by the equals(Object) method, then the string from the pool is returned. Otherwise, this String object is added to the pool and a reference to this String object is returned. It follows that for any two strings s and t, s.intern() == t.intern() is true if and only if s.equals(t) is true. All literal strings and string-valued constant expressions are interned. String literals are defined in section @jls 3.10.5 of the The Java Language Specification. Returns: a string that has the same contents as this string, but is guaranteed to be from a pool of unique strings.
6.1 intern() 详解 intern() 方法的作用就是在字符串常量池中登记常量,由于字符串常量池本身就在堆中,新创建的对象也存放在堆中,所以这种登记就是在字符串常量池中生成一个指向目标字符串对象的引用。需要注意的是,如果这个字符串是以字面量的形式创建的,那么这个字符串字面量天然就存在于字符串常量池中,换句话说就是直接在代码中写明的字符串字面量直接就在字符串常量池中登记好了。如果一个字符串是以 String s = new String() 的形式创建的,那么在调用 s.intern() 的时候,就会先在字符串常量池中已经登记过的字符串中寻找,如果找到了 s.equals(sInStringTable),就直接把字符串常量池中登记好的 sInStringTable 引用返回,如果没有找到,就在字符串常量池中创建指向这个 String 对象的引用,那么这个 String 对象就作为字符串常量登记在字符串常量池中了。intern() 方法不会对对象做任何改变,也不会对变量做任何改变。只有字符串字面量会自动存储到字符串常量池中,其他的 String 对象都需要调用 intern() 方法才能将字符串放到字符串常量池中。new 出来的 String 对象和字符串字面量在本质上是一样的,都是按照 String 对象进行存储和使用的。
6.2 场景实例详解 场景1
1 2 3 4 5 6 7 8 public void test1 () { String s = new String ("abc" ) + new String ("def" ); String intern = s.intern(); String literal = "abcdef" ; System.out.println(s == intern); System.out.println(s == literal); System.out.println(literal == intern); }
解释:由于 s 是通过两个字符串对象拼接得到,所以代码中并未出现字面常量 “abcdef”,那么字符串常量 “abcdef” 自然也就不在字符串常量池中,然后 s.intern() 在字符串常量池中登记指向字符串常量 “abcdef” 的引用,由于字符串常量池中不存在 “abcdef” 所以就将字符串常量池中指向 “abcdef” 的引用指向了 s 对象,那么在后面代码中 s 就等价于字符串常量 “abcdef” 了。调用 s.intern() 后,s 的性质就发生了变化,在内存中 s 指向的区域被认为是存储了一个字符串常量,而 s 在代码逻辑中是一个变量,所以 s.intern() 后就导致 s 虽然看起来是一个变量,但是它却指向了一个常量。新创建的 String literal = “abcdef”,让变量 literal 指向字符串常量 “abcdef”,由于 “abcdef” 已经被登记为 s,所以变量 literal 就直接指向了 s。
场景2
1 2 3 4 5 6 7 8 public void test2 () { String s = new String ("abc" ) + new String ("def" ); String literal = "abcdef" ; String intern = s.intern(); System.out.println(s == intern); System.out.println(s == literal); System.out.println(literal == intern); }
解释:通过拼接两个对象获得 s 对象,此时字符串常量池中并未登记字符串常量 “abcdef”,然后声明变量 literal 指向字面常量 “abcdef”,由于 “abcdef” 是以字面量的形式书写,所以会直接存在字符串常量池中。s.intern() 在字符串常量池中查找 “abcdef” 能够找得到就直接返回,所以此时字符串常量池中的 “abcdef” 是变量 literal 指向的那个,而不是对象 s。
场景3
1 2 3 4 5 6 7 8 9 10 11 12 13 14 public void test3 () { String s1 = new String ("abc" ) + new String ("def" ); String s2 = new String ("ab" ) + new String ("cdef" ); String s3 = new String ("a" ) + new String ("bcdef" ); System.out.println(s1 == s2); System.out.println(s1 == s3); System.out.println(s2 == s3); System.out.println(s1.equals(s2) && s1.equals(s3) && s2.equals(s3)); String literal = "abcdef" ; System.out.println(s1 == literal); }
解释:s1、s2 和 s3 尽管相互 equal,但是这在内存中是实实在在三个不同的对象,这三个 String 对象相同的地方是他们的 value 属性和 code 属性是一样的。但由于这三个对象都没有调用 intern(),所以字符串常量池中并没有 “abcdef” 这个字符串常量,直到 literal = “abcdef”,字符串常量池中才存储了 “abcdef”。对上述代码做一点修改:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 public void test3_2 () { String s1 = new String ("abc" ) + new String ("def" ); s1.intern(); String s2 = new String ("ab" ) + new String ("cdef" ); String s3 = new String ("a" ) + new String ("bcdef" ); System.out.println(s1 == s2); System.out.println(s1 == s3); System.out.println(s2 == s3); System.out.println(s1.equals(s2) && s1.equals(s3) && s2.equals(s3)); String literal = "abcdef" ; System.out.println(s1 == literal); }
解释:由于 s1 在创建后立马调用了 intern(),所以字符串常量池中注册的 “abcdef” 就直接指向了 s1,所以 literal 指向字面量 “abcdef” 也就直接指向了 s1。但是 s2 和 s3 的本质依然是通过 new 创建的,所以他们任然指向各自在内存中的位置,与 s1 互不相等。s1 调用了 intern() 但是 s2 和 s3 并没有调用,以后 s1、s2 和 s3 有什么不同吗?在调用 intern() 之前,他们被视为平等的三个变量,但是 s1.intern() 后,s1 不仅是一个变量,也是一个常量,存在字符串常量池中,那么令 s1、s2 和 s3 都置为 null 后,s2 和 s3 指向的对象实体由于没有被引用而会被垃圾回收,但是 s1 指向的对象实体由于是字符串常量池中的字符串常量,就不一定会被垃圾回收。
场景4
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 public void test4 () { String s1 = new String ("abc" ) + new String ("def" ); String s2 = new String ("ab" ) + new String ("cdef" ); String s3 = new String ("a" ) + new String ("bcdef" ); String intern1 = s1.intern(); String intern2 = s2.intern(); String intern3 = s3.intern(); System.out.println(intern1 == intern2 && intern1 == intern3 && intern2 == intern3); System.out.println(s1 == intern1); System.out.println(s1 == s2); System.out.println(s1 == s3); System.out.println(s2 == s3); String literal = "abcdef" ; System.out.println(s1 == literal); System.out.println(intern1 == literal); }
解释:s1、s2 和 s3 全部创建后依次调用 intern() 方法,由于 s1、s2 和 s3 相互 equal,所以他们的 intern() 得到的值也是相等的,由于 s1 是最早调用 intern() 的,所以字符串常量池中的 “abcdef” 就是指向 s1,s2.intern()、s3.intern() 的返回值其实就是 s1
场景5
1 2 3 4 5 6 7 8 9 public void test5 () { String literal = "abcdef" ; String s1 = new String ("abc" ) + new String ("def" ); String s2 = new String ("abcdef" ); System.out.println(s1 == s2 || literal == s1 || literal == s2); System.out.println(s1.equals(s2) && literal.equals(s1) && literal.equals(s2)); }
解释:首先通过字面常量创建变量 literal,这时字符串常量池中就有 “abcdef” 了,就是 literal。s2 和 s3 本质都是 new 出来的,都是拥有各自内存地址的对象。所以 s1、s2 和 literal 在内存的逻辑分布是:s1 和 s2 在堆的非字符串常量池区域中,但不是同一块内存,literal 在字符串常量池中。
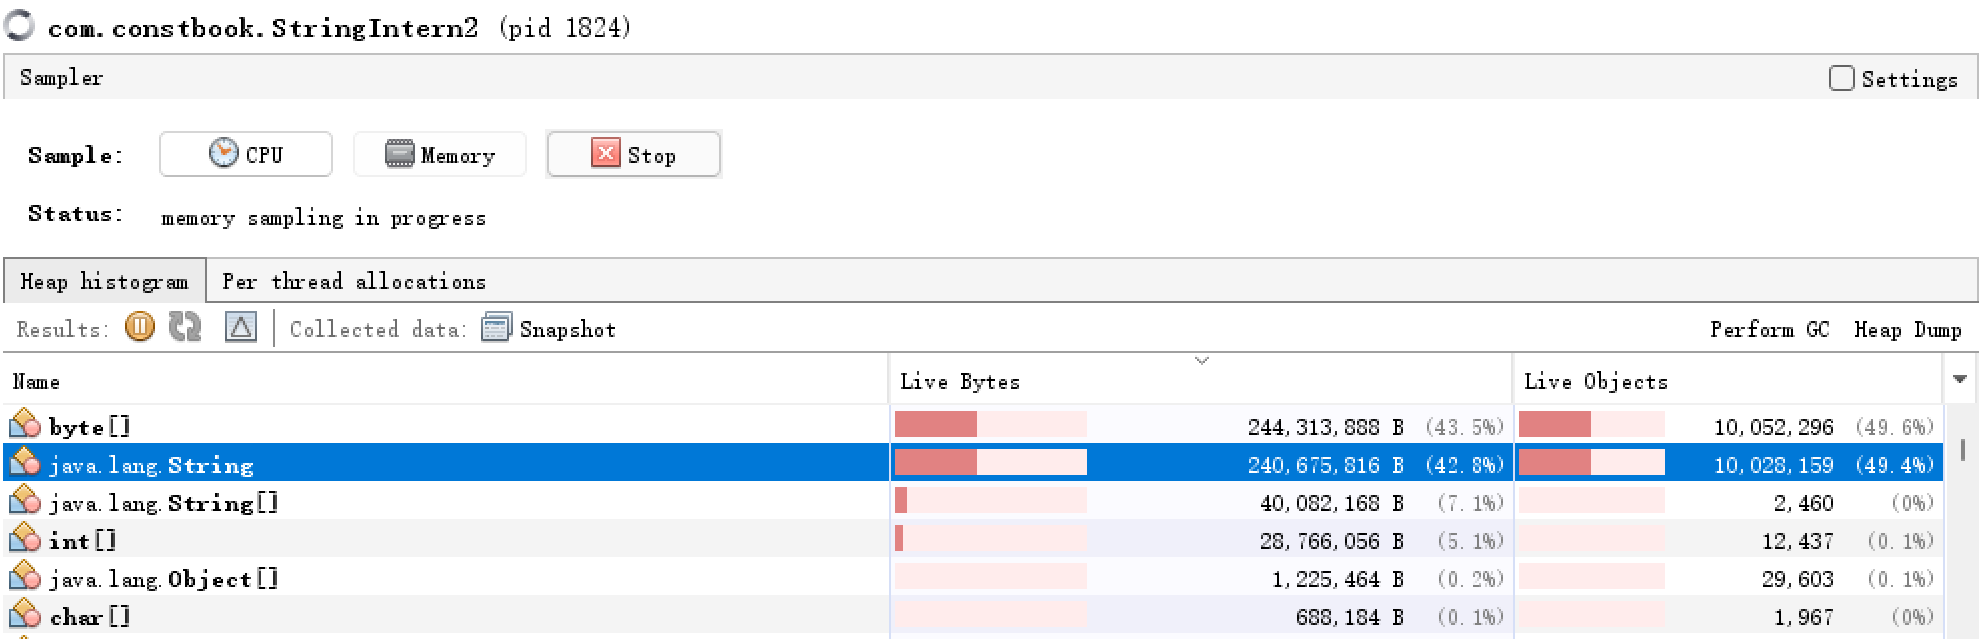
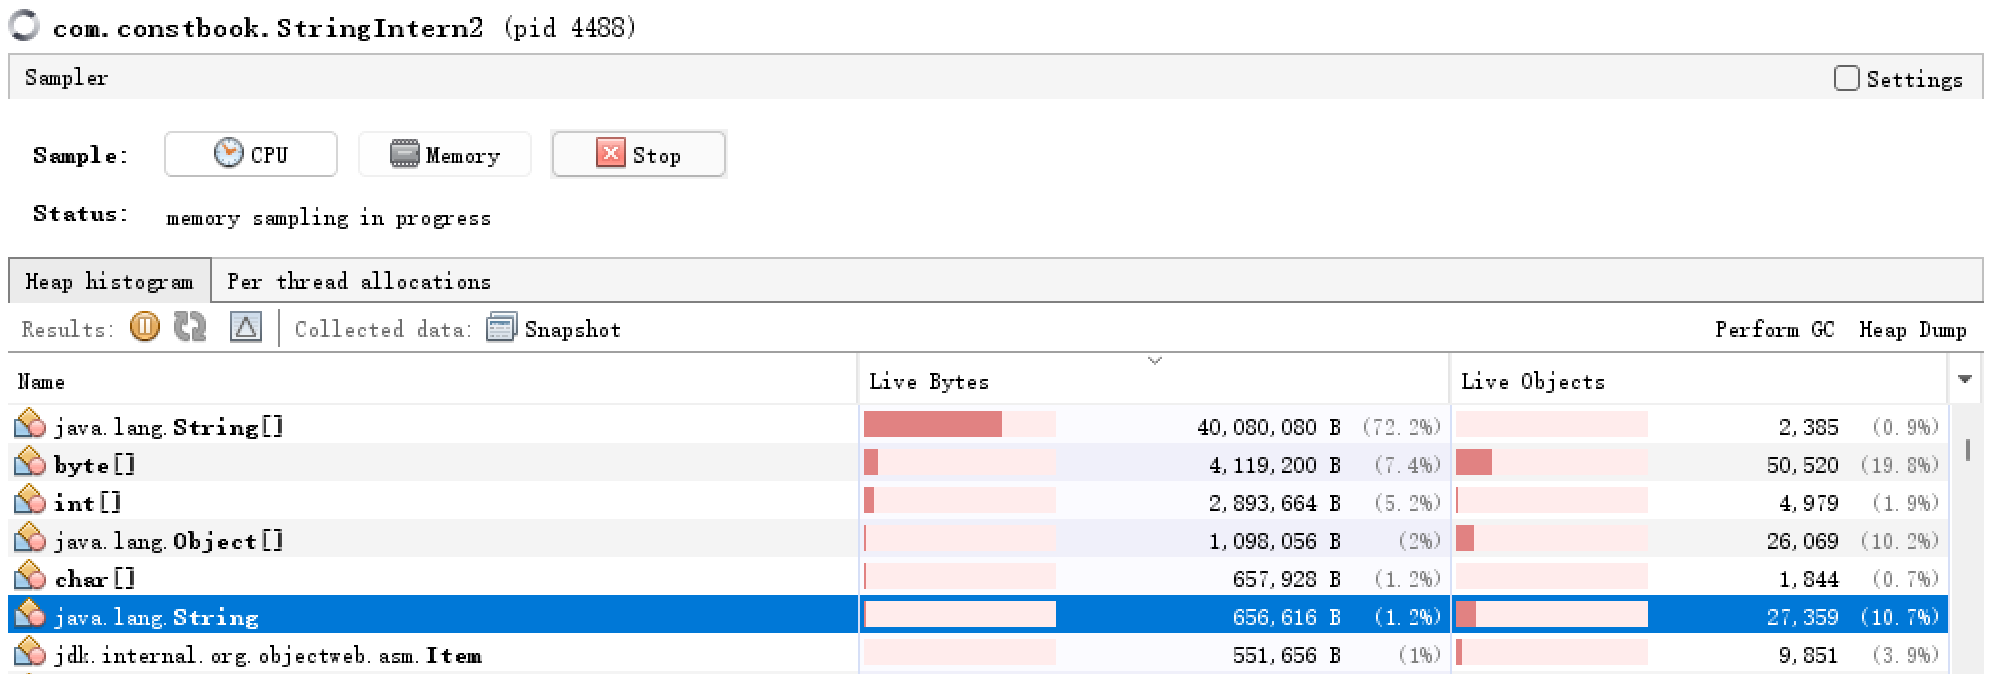
6.3 intern() 的效率测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 public class StringIntern2 { static final int MAX_COUNT = 1000 * 10000 ; static final String [] arr = new String [MAX_COUNT]; public static void main (String[] args) { Integer [] data = new Integer []{1 ,2 ,3 ,4 ,5 ,6 ,7 ,8 ,9 ,10 }; long start = System.currentTimeMillis(); for (int i = 0 ; i < MAX_COUNT; i++) { arr[i] = new String (String.valueOf(data[i % data.length])).intern(); } long end = System.currentTimeMillis(); System.out.println("花费的时间为:" + (end - start)); try { Thread.sleep(1000000 ); } catch (InterruptedException e) { e.printStackTrace(); } System.gc(); } }
1 arr[i] = new String (String.valueOf(data[i % data.length]));
1 2 arr[i] = new String (String.valueOf(data[i % data.length])).intern();
结论
对于程序中大量使用存在的字符串时,尤其存在很多已经重复的字符串时,使用 intern() 方法能够节省很大的内存空间
大的网站平台,需要内存中存储大量的字符串。比如社交网站,如果字符串都调用 intern() 方法,就会很明显降低内存的大小
7 字符串常量池的垃圾回收 1 2 3 4 5 6 7 8 public class StringTableGCTest { public static void main (String[] args) { for (int i = 100000 ; i < 200000 ; i++) { String.valueOf(i).intern(); } } }
测试结果如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 [0. 006s][info][gc] Using G1 [0. 007s][info][gc,init] Version: 17.0 .10 +11 -LTS-240 (release) ... [0. 090s][info][gc,heap ] GC(0 ) Eden regions: 6 ->0 (4 ) [0. 090s][info][gc,heap ] GC(0 ) Survivor regions: 0 ->1 (1 ) [0. 090s][info][gc,heap ] GC(0 ) Old regions: 0 ->1 [0. 090s][info][gc,heap ] GC(0 ) Archive regions: 0 ->0 [0. 090s][info][gc,heap ] GC(0 ) Humongous regions: 0 ->0 ... StringTable statistics: Number of buckets : 65536 = 524288 bytes, each 8 Number of entries : 32498 = 519968 bytes, each 16 Number of literals : 32498 = 1597696 bytes, avg 49.000 Total footprint : = 2641952 bytes ...
可以看到,Eden regions 区的内存发生了垃圾回收。
8 G1 的优化 : String 去重 许多大规模的 Java 应用的瓶颈在于内存,IBM 曾经做过一项研究,发现在这些类型的应用里面,Java 堆中存活的数据集合差不多 25% 是 String 对象,而这些 String 对象中差不多一半是重复的,也就是 str1.equals(str2) = true。堆上存在重复的 String 对象必然是一种内存的浪费。G1 垃圾收集器实现了自动持续对重复的 String 对象进行去重的功能,这样就能避免浪费内存。
但需要注意,这不是字符串常量池的去重操作,字符串常量池本身就没有重复的
8.1 实现
当垃圾收集器工作的时候,会访问堆上存活的对象,对每一个访问的对象都会检查是否是候选的要去重的 String 对象
如果是,把这个对象的一个引用插入到队列中等待后续的处理。一个去重的线程在后台运行,处理这个队列。处理队列的一个元素意味着从队列删除这个元素,然后尝试去重它引用的 String 对象
使用一个 Hashtable 来记录所有的被 String 对象使用的不重复的 char 数组。当去重的时候,会查这个Hashtable,来看堆上是否已经存在一个一模一样的 char 数组
如果存在,String 对象会被调整引用那个数组,释放对原来的数组的引用,被释放的数组最终会被垃圾收集器回收掉
如果查找失败,char 数组会被插入到 Hashtable,这样以后的时候就可以共享这个数组了
8.2 命令
-XX:-UseStringDeduplication :开启String去重,默认是不开启的,需要手动开启-XX:+PrintStringDeduplicationStatistics:打印详细的去重统计信息-XX:StringDeduplicationAgeThreshold=10 :达到 10 年龄的 String 对象被认为是去重的候选对象